OpenCVテンプレートマッチングの閾値の決め方|0.64に決めるまでの検証手順
目次
ドラクエの自動レベル上げシステムを作ったとき、コードの中にこんな行が残っていました。
threshold = 0.640.64。「なんでその数字なの?」と聞かれそうなマジックナンバーです。適当に置いた値ではなく、閾値を振って検出結果を見比べ、検出したい対象と弾きたい対象の両方から挟み込んで決めた数字でした。以下では、cv2.matchTemplate() が返す値は何なのかという仕組みから始めて、0.64にたどり着くまでの検証手順をコード付きで追いかけます。サンプルコードの 0.8 をそのまま使って「何も検出されない」「逆に画面中が赤枠で埋まる」となっている場合も、自分の画像で閾値を決める手順として読み替えられます。
🤔 threshold の数値は何と比べているのか
閾値が決められない原因の大半は、この数値が何と比較されているのかが曖昧なまま使っている点にあります。ここを押さえると、0.8ではダメで0.6なら良い理由も自分の言葉で説明できます。
cv2.matchTemplate が返すのは画像ではなく類似度マップ
テンプレートマッチングは、大きな画像(入力画像)の中から、小さな画像(テンプレート画像)と最も似ている場所を探す手法です。処理の流れは次の4ステップです📐
- テンプレート画像を入力画像の上で左上から右下へ1ピクセルずつスライドさせる
- 各位置で、テンプレートと入力画像の重なっている部分の類似度を計算する
- 計算結果を並べた2次元配列(類似度マップ)を作る
- 類似度マップの中で最も高い(手法によっては最も低い)値を持つ位置を探す
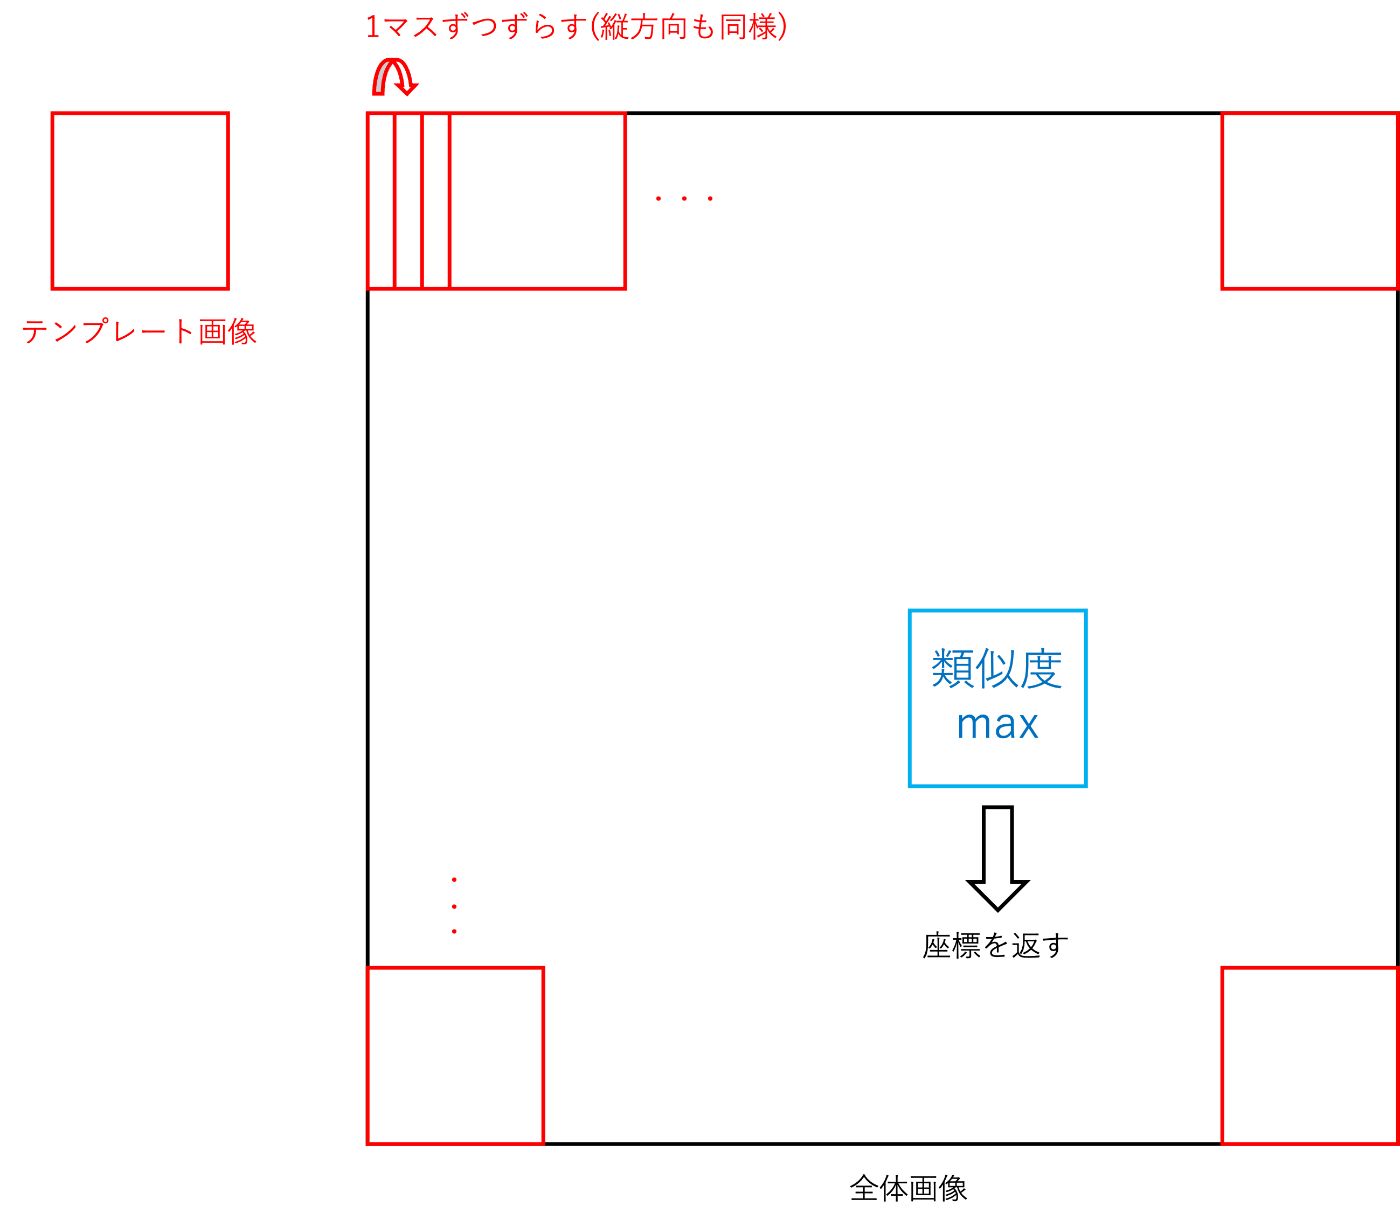
cv2.matchTemplate() の戻り値は加工された画像ではなく、「各位置にテンプレートを当てたときのスコア」が詰まった float32 の配列です。サイズも入力画像とは違い、入力画像が縦H×横W、テンプレートが縦h×横wなら、戻り値は (H - h + 1, W - w + 1) になります。スライドできる位置の数だけ値があるわけですね。
threshold は、このスコアと比較するための数値です。画像の見た目に対する閾値ではなくスコアに対する閾値だと理解しておくと、以降の話が通ります🎯
比較手法(TM_*)の違いと TM_CCOEFF_NORMED を選ぶ理由
スコアの計算方法は cv2.matchTemplate() の第3引数で指定します。OpenCVが用意しているのは次の6種類です。
| 手法 | 中身 | 良い一致のときの値 |
|---|---|---|
TM_SQDIFF |
画素値の差を2乗して合計(SSD) | 0に近いほど類似 |
TM_SQDIFF_NORMED |
SSDを正規化したもの | 0に近いほど類似(おおむね0〜1) |
TM_CCORR |
画素値の単純な積和(相関) | 大きいほど類似(値域は画素値依存) |
TM_CCORR_NORMED |
相関を正規化したもの | 1に近いほど類似 |
TM_CCOEFF |
平均を引いてから積和(相関係数の分子) | 大きいほど類似 |
TM_CCOEFF_NORMED |
正規化相関係数 | 1に近いほど類似(-1〜1) |
差の絶対値の合計(SAD)を使う手法は用意されていないので、「TM_SQDIFF_NORMED はSAD」という説明を見かけたら誤りです。あれは2乗和であるSSDを正規化したものです。
選び方の指針はこうなります。TM_SQDIFF 系や TM_CCORR は正規化されていない場合、値域が画像サイズや画素値の大きさに引きずられるため、閾値を数値で固定しづらいです。TM_CCORR_NORMED は明るさのオフセットに弱く、白っぽい平坦な領域で不自然に高いスコアが出ることがあります。TM_CCOEFF_NORMED は平均を引いてから正規化するので、明るさやコントラストの多少の違いを吸収してくれて、値域も固定されます。閾値を数値としてコードに書き込む前提なら、まずこれを選ぶのが無難です。
SQDIFF 系だけは「小さいほど類似」なので、閾値の不等号が逆になります。手法を変えたのに result >= threshold のままで「何も出ない/全部出る」になるのは定番のつまずきです😇
正規化相関係数の式を分解して読む
入力画像を I、テンプレート画像を T とします。検索窓が位置 (x, y) にあるとき、入力画像の検索窓領域とテンプレート画像の画素を、それぞれ一列に並べた1次元ベクトルだと考えてください。
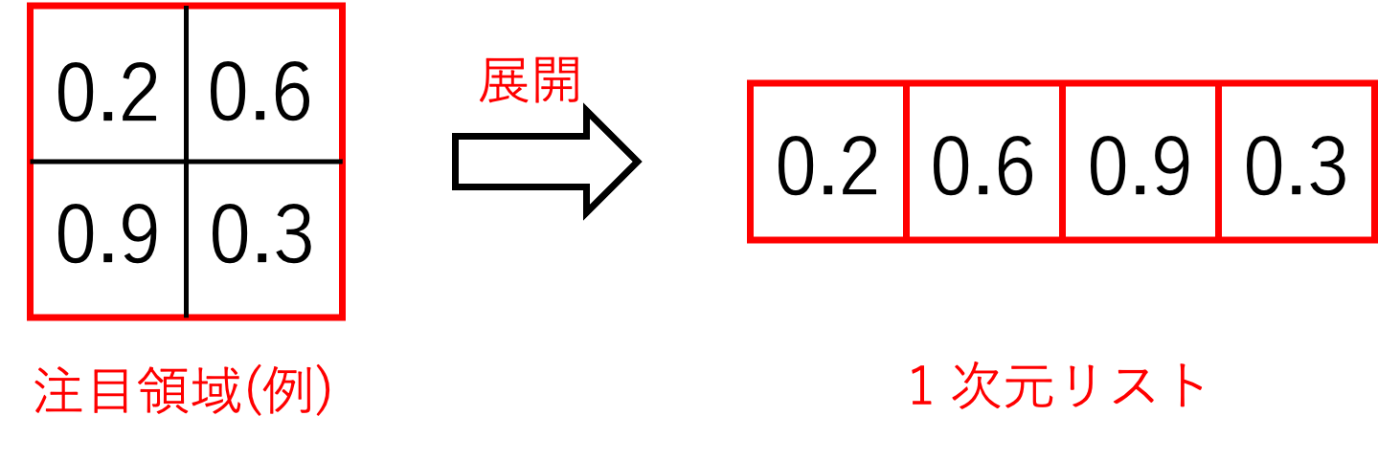
正規化相関係数の計算は、この2本のベクトルの向きがどれだけ揃っているかを見る作業です。プレーンテキストで書くと次の形です。
                 Σ(i,j) [ T'(i,j) * I'(x+i, y+j) ]
ccoeff(x,y) = ------------------------------------------------------
              sqrt( Σ(i,j) T'(i,j)^2 * Σ(i,j) I'(x+i, y+j)^2 )

T'(i,j)     = T(i,j)      - (テンプレート全画素の平均)
I'(x+i,y+j) = I(x+i,y+j)  - (その検索窓内の全画素の平均)

Σ(i,j) は i = 0..w-1, j = 0..h-1 の総和(w, h はテンプレートの幅と高さ)
カラー画像の場合はチャンネル方向にも足し合わせる
分子はテンプレート側 T’ と入力側 I’ の積であって、T’ 同士の積ではありません(ここを取り違えると、ただの2乗和になってしまいます)。
やっていることは、両者から「その領域の平均の明るさ」を引いて、平均からのズレのパターンだけを比べる、ということです。分母で両ベクトルの長さで割っているので、コントラストの強弱も打ち消されます。だから「全体的に暗い」「全体的に白っぽい」といった差では値が下がりにくく、模様や輪郭の形が一致しているかどうかが効いてきます✨
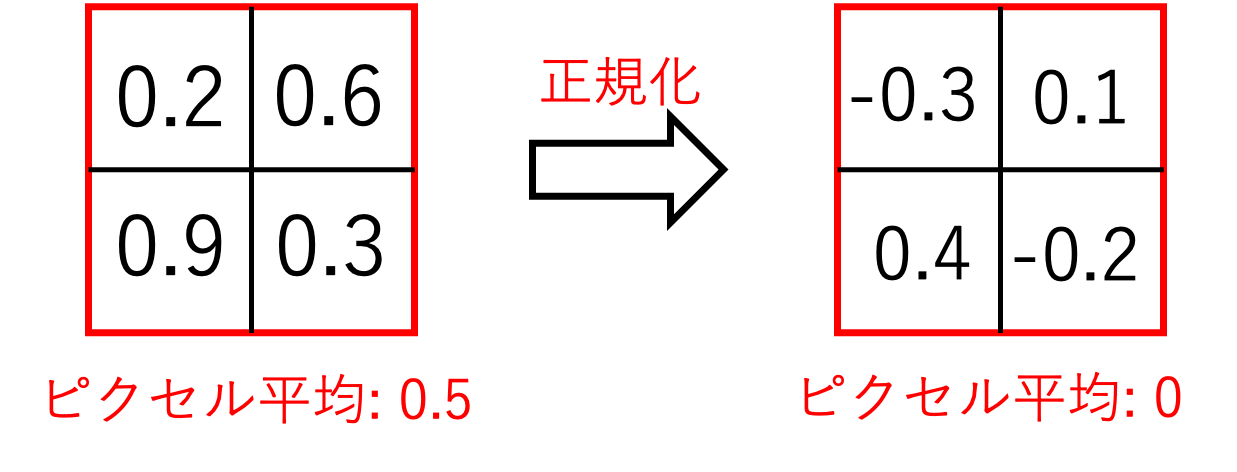
値域が [-1, 1] と分かると閾値の感覚がつかむ
TM_CCOEFF_NORMED の値域は -1 から 1 です。1 は明暗のパターンがぴったり一致、0 は無相関、-1 はネガポジ反転のように真逆のパターンです。
ここから、閾値の相場観が立ちます。
- テンプレートを入力画像そのものから切り出した場合、その場所は 1.0 に近い値が出ます
- スクリーンショットの世代が違う、アンチエイリアスがかかる、背景が違うといった条件では 0.7〜0.9 あたりに落ちます
- 「輪郭が似ているだけの別物」でも 0.5〜0.7 は平気で出ます😇
0.8以上だけを拾う設定は「テンプレートとほぼ同一条件の画像」を前提にした強めの値で、実運用の画面から切り出したテンプレートだとしばしば何も引っかかりません。逆に0.3〜0.4では、輪郭だけ似ている無関係な領域まで大量に拾います。閾値は自分の画像で実測して決めるしかない、という結論はここから来ます。
🧪 閾値を探すための検証コード:ヒートマップと検出枠を並べて出す
閾値を決めるには、スコアの分布と検出結果を同時に目で見るのがいちばん早いです。左に類似度マップのヒートマップ、右に閾値以上の位置へ赤枠を描いた画像を並べて表示します。
コード全文
import cv2
import numpy as np
import matplotlib.pyplot as plt

# 画像とテンプレートの読み込み
base = cv2.imread('../img/base.png', cv2.IMREAD_COLOR)
template = cv2.imread('../img/lost_metal.png', cv2.IMREAD_COLOR)

# テンプレートを34x26に縮小
template = cv2.resize(template, (34, 26), interpolation=cv2.INTER_AREA)

# テンプレートマッチングの実行
result = cv2.matchTemplate(base, template, cv2.TM_CCOEFF_NORMED)

# 閾値を設定
threshold = 0.65  # 類似度がこの値以上の場所に赤枠を描画

# 閾値以上の位置を取得
locations = np.where(result >= threshold)

# ヒートマップの生成
heatmap = cv2.normalize(result, None, alpha=0, beta=255, norm_type=cv2.NORM_MINMAX, dtype=cv2.CV_8U)
heatmap = cv2.applyColorMap(heatmap, cv2.COLORMAP_HOT)

# 赤枠を元画像に描画
base_with_rectangle = base.copy()

# 閾値を超えた位置に赤枠を描画
for pt in zip(*locations[::-1]):  # locations は (y, x) のタプルなので反転して (x, y) に
    top_left = pt
    bottom_right = (top_left[0] + template.shape[1], top_left[1] + template.shape[0])
    cv2.rectangle(base_with_rectangle, top_left, bottom_right, (0, 0, 255), 2)

# 結果を表示
plt.figure(figsize=(12, 6))

# ヒートマップの表示
plt.subplot(1, 2, 1)
plt.title('Similarity Heatmap')
plt.imshow(heatmap)
plt.axis('off')

# 赤枠を描画した画像の表示
plt.subplot(1, 2, 2)
plt.title('Detected Area')
plt.imshow(cv2.cvtColor(base_with_rectangle, cv2.COLOR_BGR2RGB))
plt.axis('off')

plt.show()画像パスは自分の環境に合わせて置き換えてください。cv2.imread() はファイルが見つからないときに例外ではなく None を返すので、後続で cv2.error が出たらまずパスを疑うのが定石です。
テンプレートをリサイズしてから渡している理由
テンプレートマッチングは、拡大縮小や回転に対して不変ではありません。テンプレートが実際の画面上の対象より大きい/小さいだけで、スコアはあっさり落ちます📉
このコードで (34, 26) に縮小しているのは、入力画像の中に写っている対象のピクセルサイズに合わせるためです。テンプレートを別の解像度の画面から切り出した場合、まず対象の実寸を測って、その大きさにテンプレートを合わせます。縮小のときは INTER_AREA が定番で、平均化されるのでモアレや不自然なジャギーが出にくいです。
もう一つの制約として、テンプレートは入力画像より小さくなければいけません。逆になっていると matchTemplate はエラーになります。それと、テンプレートに背景が多く入っていると、背景が変わったときにスコアが不安定になります。可能なら対象の輪郭ぎりぎりで切り出すか、背景がほぼ一定の場面を選ぶのが無難です。
np.where で閾値以上の座標を取り出す部分の読み方
np.where(result >= threshold) は、条件を満たす要素のインデックスをタプルで返します。2次元配列なので中身は (行インデックスの配列, 列インデックスの配列)、つまり (yの配列, xの配列) の順です。
OpenCVの描画関数は (x, y) の順で座標を受け取るため、そのまま渡すと縦横が入れ替わって枠が変な場所に出ます。そこで locations[::-1] でタプルの並びを反転し、zip() で (x, y) のペアとして取り出しています🔀
右下座標は、左上座標にテンプレートの幅と高さを足して作ります。template.shape は (高さ, 幅, チャンネル) の順なので、幅は shape[1]、高さは shape[0] です。ここの添字を逆にすると枠の縦横比が崩れるので、検出位置は合っているのに枠がずれて見えるときはまずここを確認してください。
対象が画面に1つだけだと決め打ちできるなら、np.where ではなく cv2.minMaxLoc(result) で最大値とその座標を取るほうが簡単です。閾値を決める段階でも、result.max() を print して「いちばん自信があるスコアはいくつか」を数値で見るのは有効です。
ヒートマップ側で見るべきポイント
ヒートマップで見るべきは、明るい点が「対象の位置にだけ」立っているかどうかです。理想は、狙った対象の場所が明るく、そのほかは暗く沈んでいる状態です。対象以外の場所にも同じくらい明るい点が散っているなら、閾値をどこに置いても誤検出と取りこぼしのどちらかが避けられません。テンプレートの切り出しやサイズを直すべきサインです。
⚠️ 一つ注意があります。上のコードのヒートマップは NORM_MINMAX で0〜255に引き伸ばしているため、色は「その画像の中での相対的な高さ」しか表していません。スコアが全体的に低くても、いちばん高い場所は真っ白に見えます。絶対値を見たいなら、ヒートマップの色ではなく result.min() と result.max() を数値で確認してください。閾値はあくまで絶対値で比較されます。
🎚️ 閾値を 0.4 / 0.6 / 0.8 で振って検出結果を比べる
同じ入力画像・同じテンプレートに対して、threshold だけを 0.4、0.6、0.8 に変えて走らせます。赤枠で囲まれた部分が、閾値以上の類似度を持つと判定された領域です。
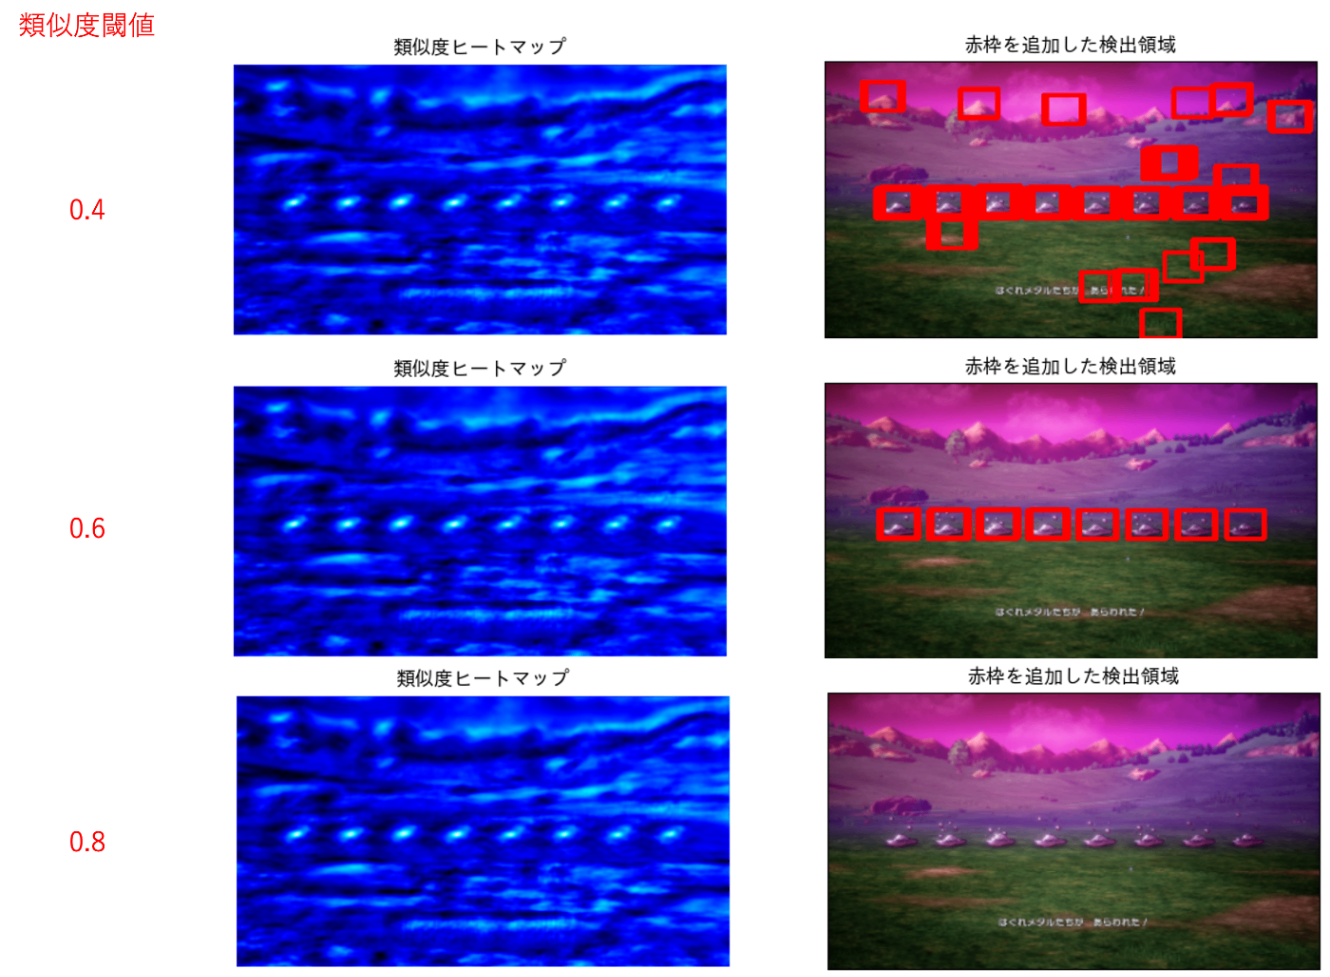 画像出典:ドラゴンクエストIII そして伝説へ…(HD-2D版) © SQUARE ENIX
低すぎる閾値で起きること
0.4では、狙った対象は当然検出できますが、それ以外の場所にも赤枠が付きます。取りこぼしはないものの、当たりかどうかの判断を後段に押しつけている状態です。
自動化スクリプトの中でこれをやると厄介です。検出された座標をもとに次の操作へ進む設計なら、誤検出の座標を信じて誤った操作をしてしまいます。しかも誤検出は入力画像の内容によって出たり出なかったりするので、「たまに変な挙動をする」という再現性の低いバグになります。低いほど安全というわけではありません。
高すぎる閾値で起きること
0.8では、逆に赤枠がほとんど付かなくなります。テンプレートと入力画像がまったく同じ描画条件でないかぎり、スコアは1.0には届きません。対象がわずかに動いている、アニメーションで形が変わっている、背景が違う、それだけで0.8は超えなくなります🙅
サンプルコードで 0.8 や 0.9 を見かけることが多いのは、テンプレートを入力画像そのものから切り出した例が多いためです。自分の画像に持ち込んだ瞬間に成立しなくなる前提だと思っておくのが安全です。「まったく検出されない」ときは、まず閾値を0.3くらいまで下げて result.max() を確認し、そもそも最大スコアがいくつなのかを測るところから始めます。
この時点で 0.6 前後が候補になる
0.4と0.8の中間である0.6では、狙った対象に赤枠が集中し、余計な検出も目立ちません。「だいたい0.6くらいが良さそう」という感触が得られます。
ただしこれは「検出したい対象が検出できる下限」を見ただけです。閾値を決めるには、「これは検出してはいけない」という対象を弾けるかどうかも確かめる必要があります。
👯 見た目がそっくりな対象を誤検出する問題
今回のケースでは、狙っていた対象(はぐれメタル)と非常に見た目が似たモンスターが登場します。バブルスライムです。色は緑ですが、それ以外の形状はほぼ一致しています🫧
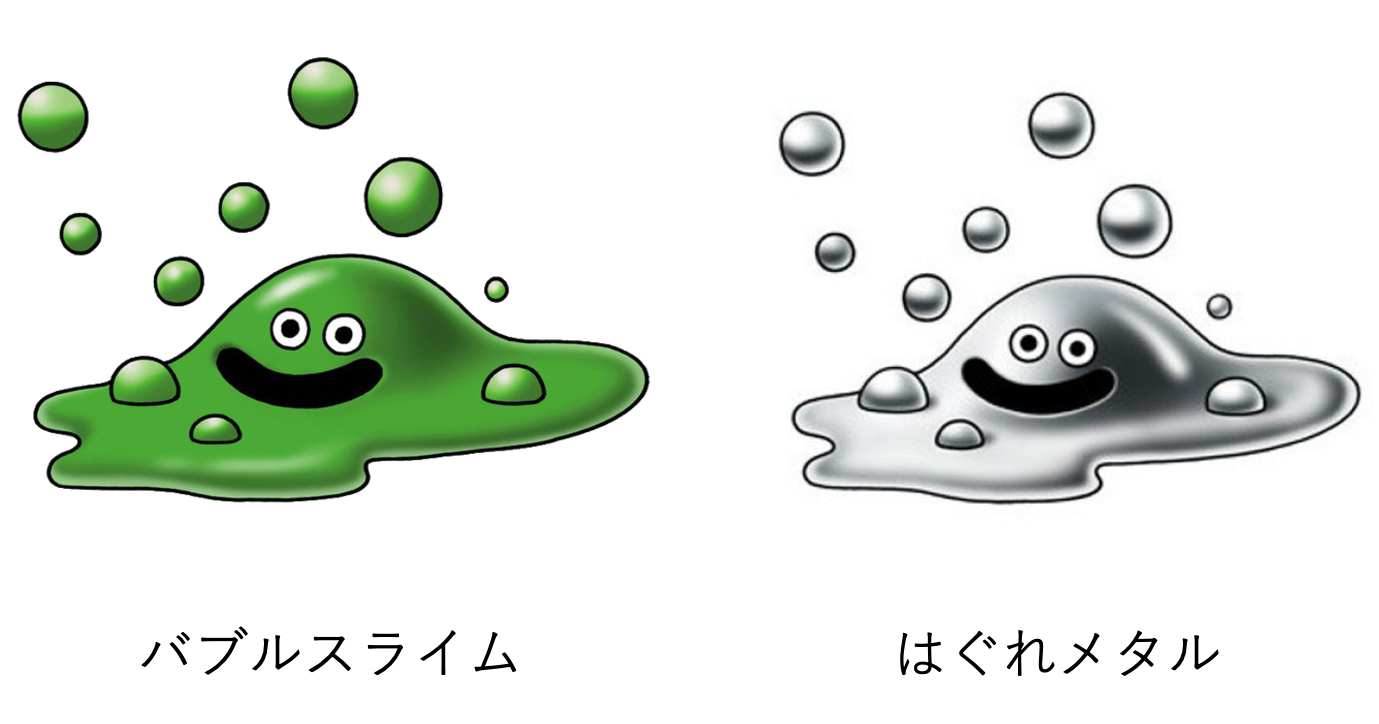 画像出典:ドラゴンクエストIII そして伝説へ…(HD-2D版) © SQUARE ENIX
こうした「色は違うが形は同じ」対象が画面に混在すると、閾値0.6では両方に赤枠が付いてしまいます。区別できてはじめて実用になります。
色が違っても区別しにくい理由(グレースケール化の影響)
まず誤解を解いておきます。cv2.matchTemplate() は内部で勝手にグレースケール化したりしません。cv2.IMREAD_COLOR で読み込んだ3チャンネルの画像をそのまま渡せば、BGRの全チャンネルを使ってスコアが計算されます(入力画像とテンプレートのチャンネル数が一致していることが条件です)。「OpenCVはグレースケールで比較するから色が使えない」というのは正確ではありません。
では、なぜ色が違うのに区別しにくいのか。理由は TM_CCOEFF_NORMED の性質にあります。前半で見たとおり、この手法は各領域の平均を引き、ベクトルの長さで割ります。「全体的に色味がずれている」「全体的に明るい/暗い」といった一様なオフセットは、意図的に打ち消される設計です。残るのは明暗パターンの形、実質的には輪郭やハイライトの配置です。形がそっくりな相手には、色が違っても高いスコアが出ます。
💡 もし自分で cv2.IMREAD_GRAYSCALE を使ったり cv2.cvtColor() で変換してからマッチングしていると、今度は本当に色の情報が消えます。色で区別したいのに前処理でグレースケールにしているなら、そこは見直しポイントです。色の差を積極的に使いたい場合は、HSVのHチャンネルでマスクを作って候補を絞る、検出後に枠内の平均色をチェックする、といった後処理を足すほうが確実です。今回は閾値だけで区別できるかを詰めていきます。
弾きたい側をテンプレートにして上限を探る
閾値の上限を探るには、弾きたい対象そのものをテンプレートにして、まったく同じ検出コードを走らせます。今回はバブルスライムをテンプレートに差し替えました。
見たいのは「バブルスライムが検出されなくなる閾値はどこか」です。この値を下回る閾値を使うとバブルスライムを誤検出してしまう、という上限が分かります。テンプレートを差し替えるだけで、コードの他の部分は一切変えません。条件を揃えないと数値を比較できないからです。
0.62 / 0.63 / 0.64 で挙動が変わる境界
0.6前後が候補だと分かっているので、その周辺を細かく刻みます。0.62、0.63、0.64で試した結果はこうなりました。
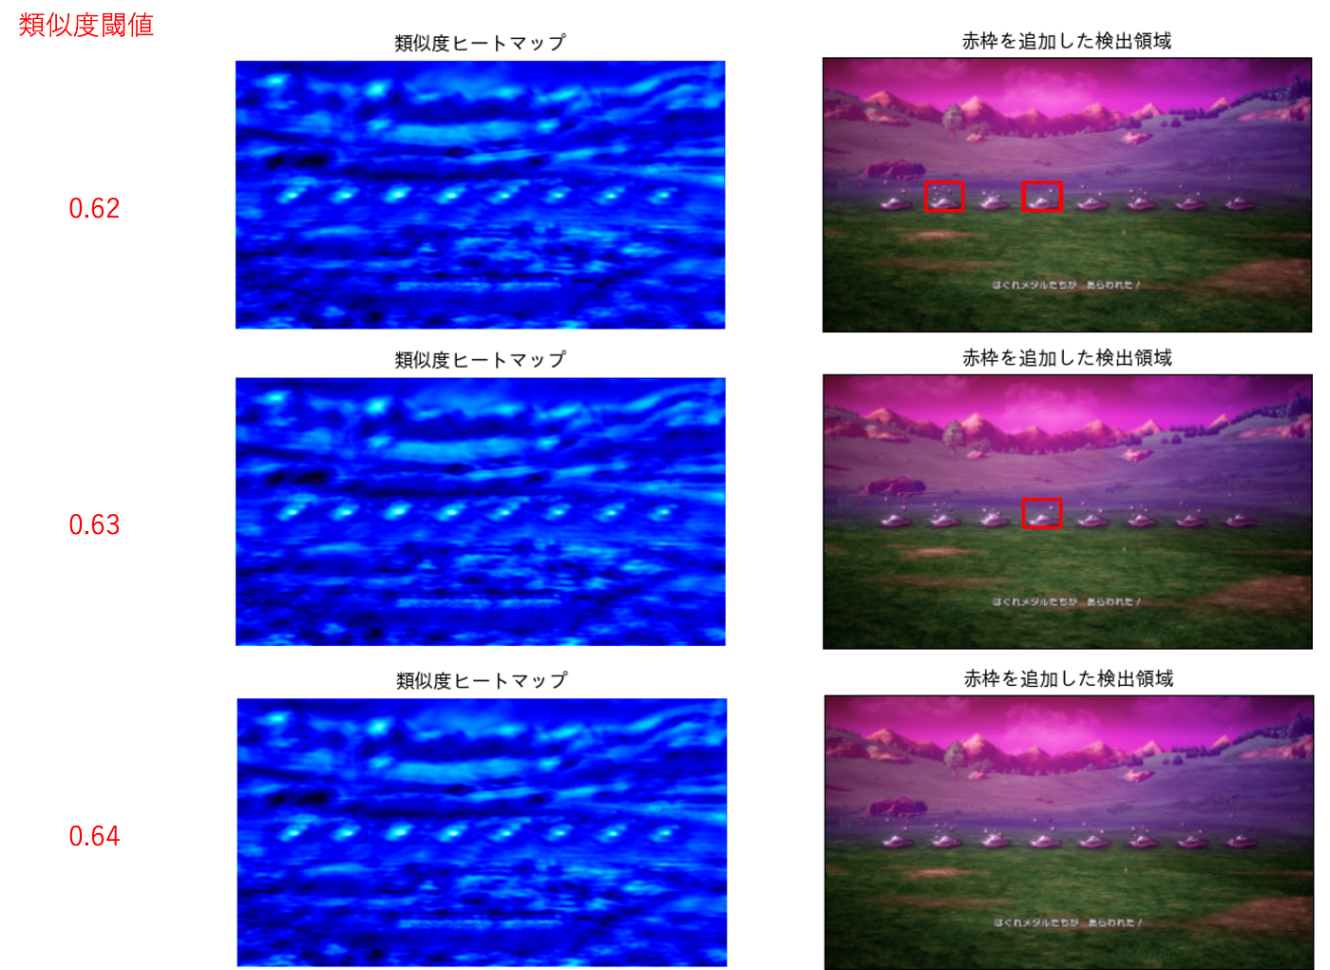 画像出典:ドラゴンクエストIII そして伝説へ…(HD-2D版) © SQUARE ENIX
💡 バブルスライムが検出されなくなるギリギリの閾値は、経験則として0.64以上と言えそうです。0.1刻みでは見えなかった境界が、0.01刻みにすると現れます。候補が絞れてからは刻みを細かくする、という進め方が効いてきます。
刻みを手で変えるのが面倒なら、閾値だけをループさせて検出数を数える形にすると、境界を一覧で確認できます。
for th in [0.60, 0.61, 0.62, 0.63, 0.64, 0.65, 0.70]:
    n = int((result >= th).sum())
    print(f'threshold={th:.2f} -> {n} px over')
🏁 0.64 に決めた根拠と最終確認のやり方
検出したい対象と弾きたい対象の両方で同じ閾値を走らせる
最終確認として、閾値を0.64に固定したまま、テンプレートだけをはぐれメタルとバブルスライムで入れ替えて比較しました。
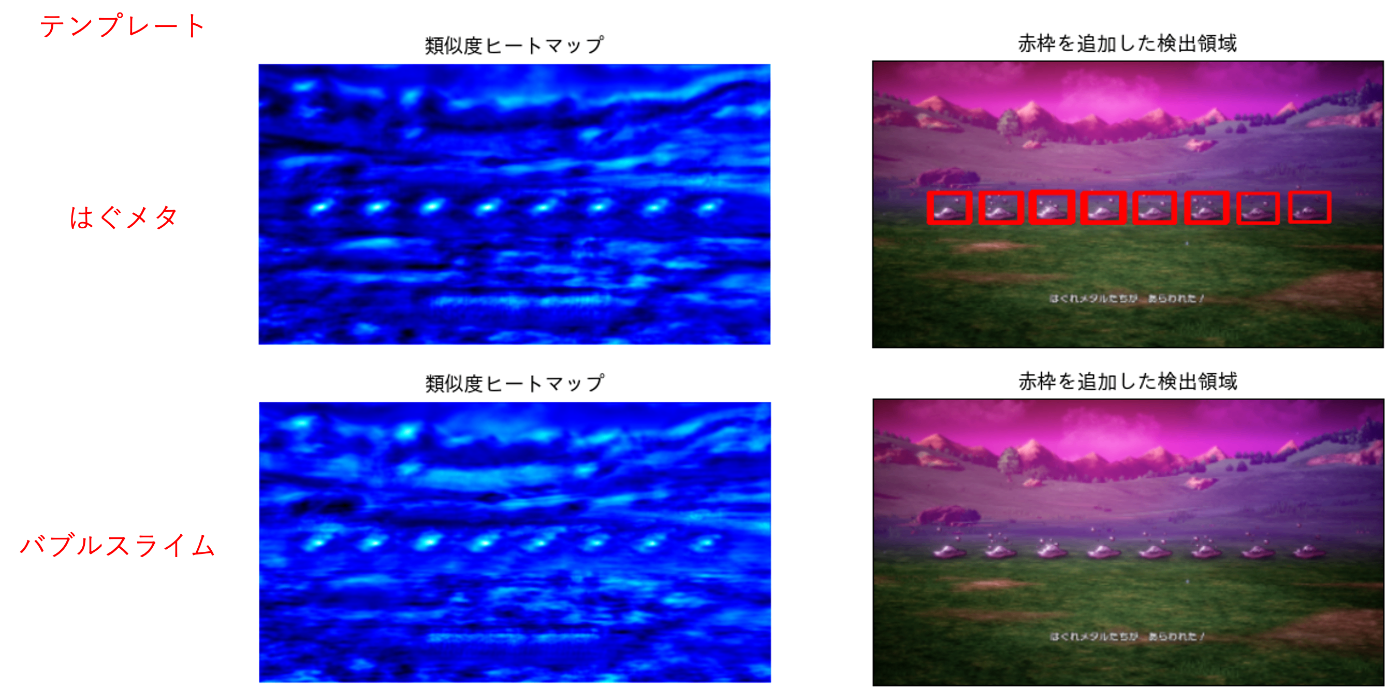 画像出典:ドラゴンクエストIII そして伝説へ…(HD-2D版) © SQUARE ENIX
はぐれメタル側には赤枠がたくさん付き、バブルスライム側には一つも付きません。同じ閾値で、検出したい対象は拾い、弾きたい対象は落とせています。これが0.64の根拠です。
この確認の形は応用が利きます。閾値を1つ固定し、テンプレート(あるいは入力画像)を「拾いたいケース」と「拾ってはいけないケース」で切り替えて、両方が期待どおりになるかを見る。テストケースを2本用意する、という発想です🧪
下限と上限で挟み込む考え方
やったことを整理すると、閾値の決め方は2方向からの挟み込みです。
下限:検出したい対象がスコアを下回らないライン(今回は 0.6 前後で検出できた)
上限:弾きたい対象がスコアを超えてしまうライン(今回は 0.64 未満だと拾ってしまう)

  → 使える閾値の範囲 = 下限 以上 かつ 上限 より上
片側だけを見て決めると失敗します。「検出できたからOK」で止めると誤検出に足をすくわれますし、「誤検出がなくなったからOK」で上げすぎると本命を取りこぼします。両側を測って初めて、閾値を置ける区間が確定します。
もしこの区間が存在しない、つまり弾きたい対象のスコアが検出したい対象のスコアを上回ってしまう場合、閾値のチューニングでは解決しません。テンプレートの切り出し範囲を変える(相手と違う部分を含める)、色で絞り込む、比較手法を変える、といった前提のほうを直す必要があります。
余裕を取るかギリギリを狭めるかの判断
区間が決まったら、その中のどこに置くかです。判断軸は「どちらのミスがより痛いか」です🤔
- 誤検出が致命的(誤った座標で操作してしまう)なら、区間の上側に寄せる
- 取りこぼしが致命的(出現を見逃すと機会を失う)なら、区間の下側に寄せる
- どちらも同程度なら、区間の中央あたりに置いて余裕を持たせる
今回は0.64、つまり上限ぎりぎりを選びました。狙った対象は画面上に何度も現れ、1フレーム見逃しても次のフレームで拾い直せる一方、似たモンスターを誤検出すると想定外の挙動につながるため、誤検出を避ける側に寄せるのが妥当だと判断しています。
ただし上限ぎりぎりは、条件が少し変わると崩れやすい設定でもあります。画面の解像度やスケーリングを変えた、ゲーム側の描画が変わった、といったときには再測定が必要になります。そのつもりで運用するなら問題ありませんが、長期間ノーメンテで回したいなら区間の中央寄りにして余裕を確保するほうが安定します。
🧭 自分の画像で閾値を決めるときの手順とつまずきどころ
手順を4ステップに整理する
ここまでの流れは、対象が何であっても使えます🙌
- 狙った対象を、入力画像に写っているのと同じピクセルサイズで切り出す。サイズが違うなら
cv2.resize()で合わせ、背景の写り込みは最小限にする。 - 閾値を0.3程度に下げるか、
cv2.minMaxLoc(result)やresult.max()を print して、狙った対象の位置でスコアがいくつ出るかを実測する。ここが0.5にも届かないなら、閾値をいじる前にテンプレート側を直す。 - 0.4 / 0.6 / 0.8 のように0.2刻みで当たりを付け、候補が見えたら0.01刻みで境界を探す。ヒートマップと赤枠を並べて表示し、目で確認する。
- 似た対象や誤検出しがちな背景をテンプレート(または入力画像)にして同じコードを走らせ、上限を測る。下限と上限で挟み込み、どちらのミスが痛いかで最終値を決める。
同じ対象に枠が重なって大量に出るとき
np.where で閾値以上の座標を全部拾うと、1つの対象に対して隣接ピクセル分の枠が何十個も重なって描かれます。上の検証画像で赤枠が太く見えているのも、これが原因です。
検証段階では「どのあたりが高スコアか」が分かるので、むしろ重なったままのほうが見やすいです。困るのは実運用で座標を1つに確定したいときで、対処は3通りあります🛠️
- 対象が1つだけなら
cv2.minMaxLoc(result)で最大値の位置だけを使う - 複数ある場合は、検出した矩形リストを
cv2.groupRectangles()でまとめる、あるいは自分でNMS(重なり率の高い枠のうちスコア最大のものだけ残す処理)を書く - 手軽に済ませるなら、すでに採用した枠から一定距離以内の候補は捨てる、という単純な間引きでも実用になります
いずれにしても、閾値の話と枠の重複の話は別問題です。「同じ対象に枠が10個出るから閾値が高すぎる/低すぎる」と考えると判断を誤るので、切り分けておいたほうがいいです。
テンプレートのサイズや解像度が変わると閾値も変わる
決めた閾値は、そのテンプレートとその入力画像の組み合わせに対する値です。次の条件が変わったら、再測定が前提になります。
- 画面の解像度やウィンドウサイズ、ディスプレイのスケーリング設定
- テンプレートのリサイズ後のサイズや補間方法
- 画像の圧縮(JPEGなど)の有無や強さ🗜️
- 明るさ設定、夜間フィルタのような画面全体にかかる演出
- 対象のアニメーション(同じキャラでもフレームによって形が違う)
とくに解像度の変化は影響が大きいです。テンプレートマッチングはスケール不変ではないので、対象が数ピクセル大きいだけでスコアが目に見えて落ちます。複数の解像度に対応したいなら、テンプレートを何段階かのサイズで用意してそれぞれマッチングする(マルチスケール化)か、入力画像を基準解像度にリサイズしてから処理するのが現実的です。
閾値の根拠をコードに残しておく
冒頭の反省点がここです。threshold = 0.64 だけが残っていると、後から見た自分でも「なぜ0.64?」となります。少なくとも、どうやって決めた値なのかはコメントで残しておきましょう。
# はぐれメタル検出の閾値
# 0.6 前後で検出可、0.64 未満だと見た目の似たモンスターを誤検出したため上限ぎりぎりを採用
# テンプレートは 34x26 に縮小したものを前提。解像度を変えたら再測定が必要
THRESHOLD_LOST_METAL = 0.64
マジックナンバーそのものを消せなくても、「どの条件で、何を根拠に決めたか」が書いてあれば、条件が変わったときに何を測り直せばよいか分かります。定数名を付けて1か所にまとめておくと、再測定のときに書き換える箇所が散らばりません。
🎁 まとめ:閾値は勘で置かず、振って挟み込んで決める
cv2.matchTemplate() の threshold は、画像の見た目ではなく類似度マップのスコアに対する閾値です。TM_CCOEFF_NORMED なら値域は -1 から 1 で、平均を引いて正規化する仕組み上、明るさや色の一様なずれは打ち消され、形の一致が効きます。この性質を知っていれば、「色違いでそっくりな対象が誤検出される」という現象も納得できます🧠
決め方の骨子は、検出したい対象で下限を測り、弾きたい対象で上限を測り、その区間の中からどちらのミスが痛いかで最終値を選ぶ、という挟み込みです。今回は粗く0.4 / 0.6 / 0.8で当たりを付け、0.62 / 0.63 / 0.64で境界を詰めて0.64に決めました。サンプルコードの0.8をそのまま使っても、自分の画像では成立しないことがほとんどです。
画像認識と聞くとニューラルネットワークを学ばないと手が出せない印象がありますが、OpenCVのテンプレートマッチングは仕組みが追えるぶん、うまくいかない理由も自分で切り分けられます。閾値で悩んだときは、ヒートマップと検出枠を並べて表示するコードを1本用意して、実際に数値を振ってみてください。各関数の引数や比較手法の細かい仕様はバージョンによって記述が変わることがあるので、最終的には公式ドキュメントで確認してください。